


主营:
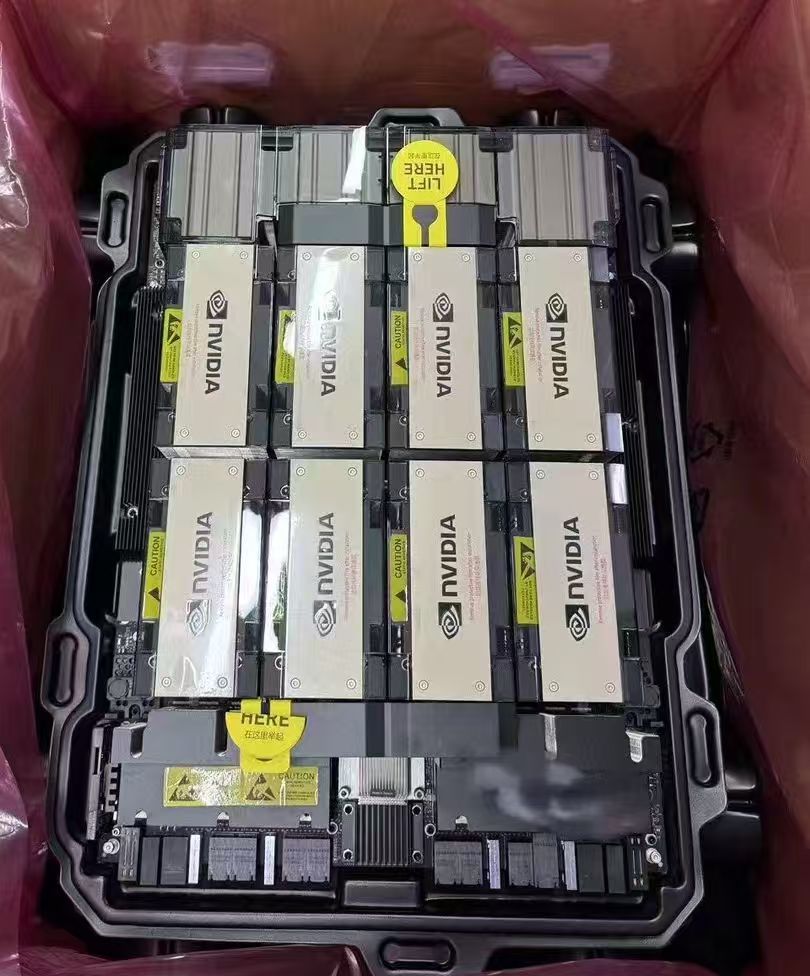
GPU/CPU/嵌入式二手拆新服务器配件/芯片HGX模组光模块/高速线缆
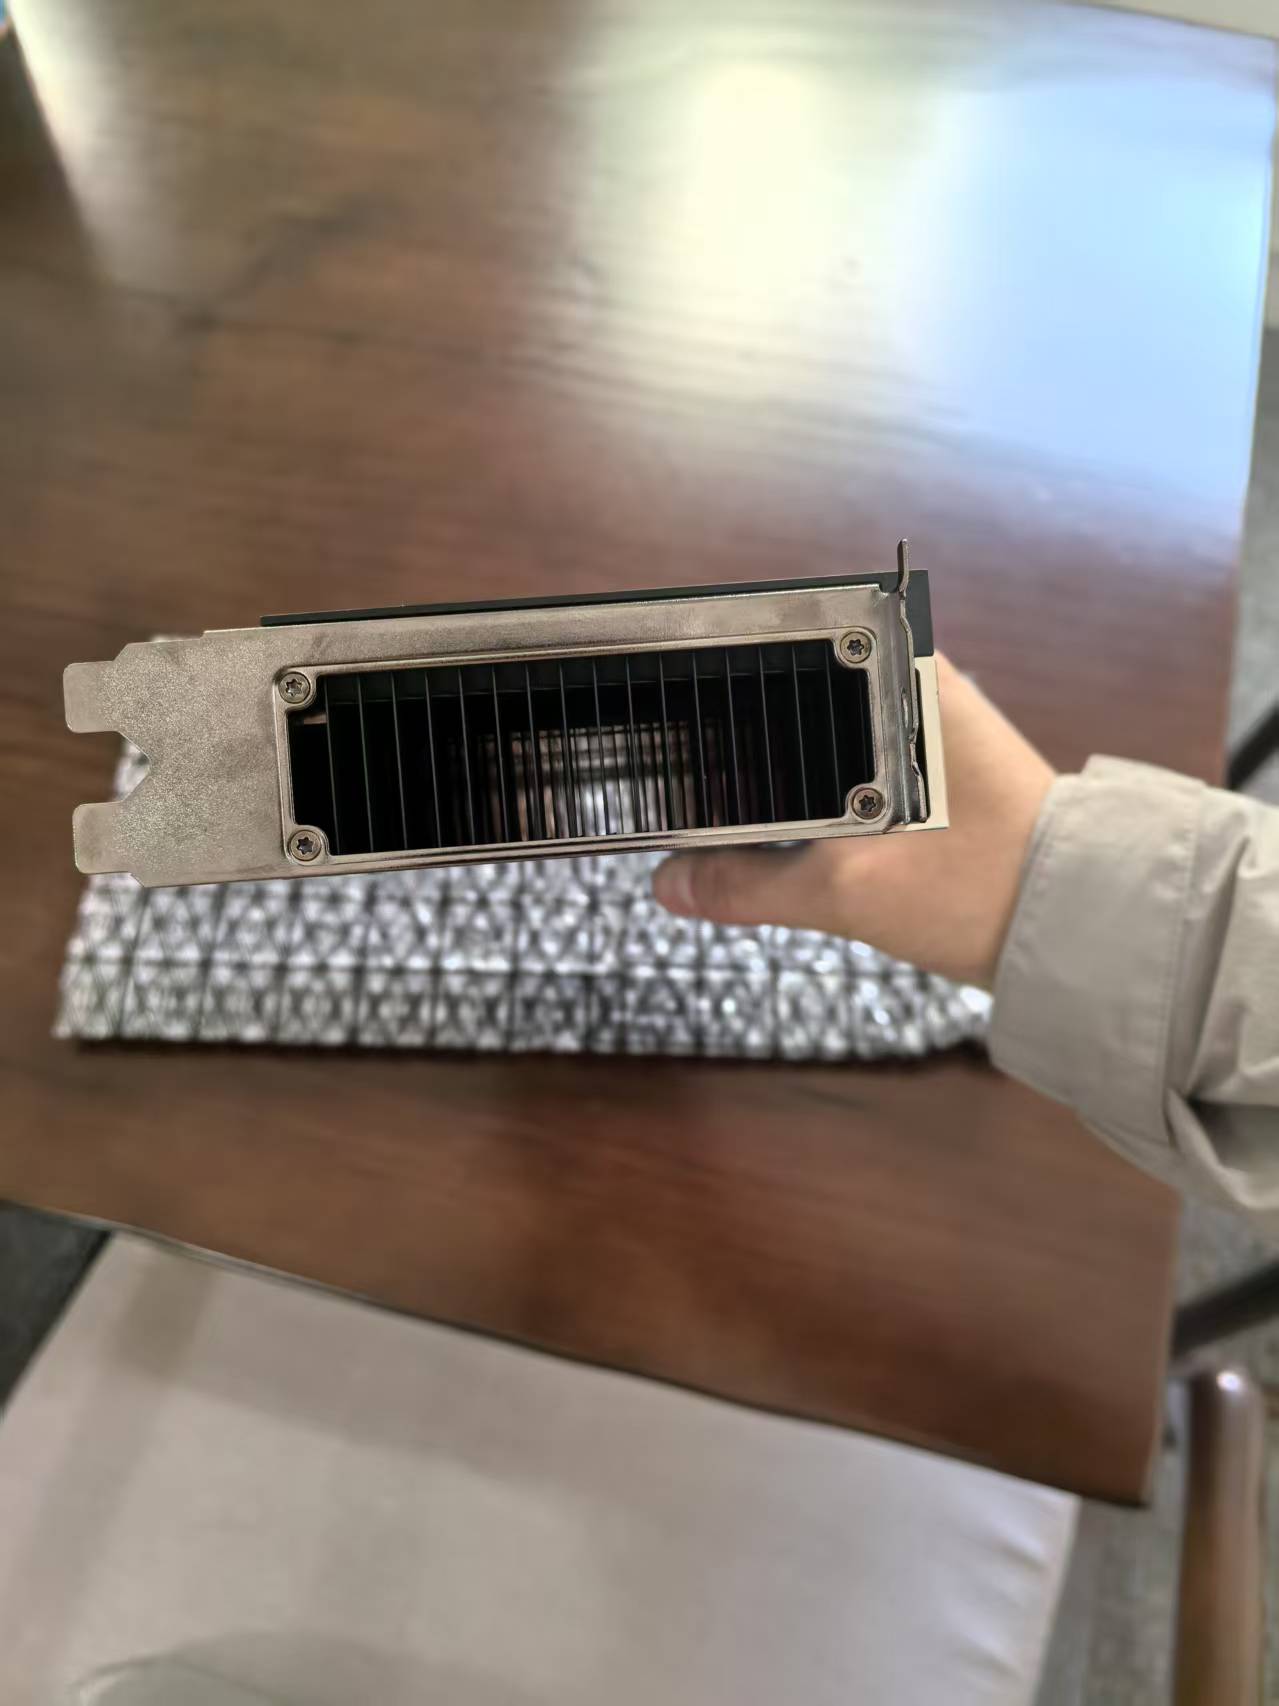
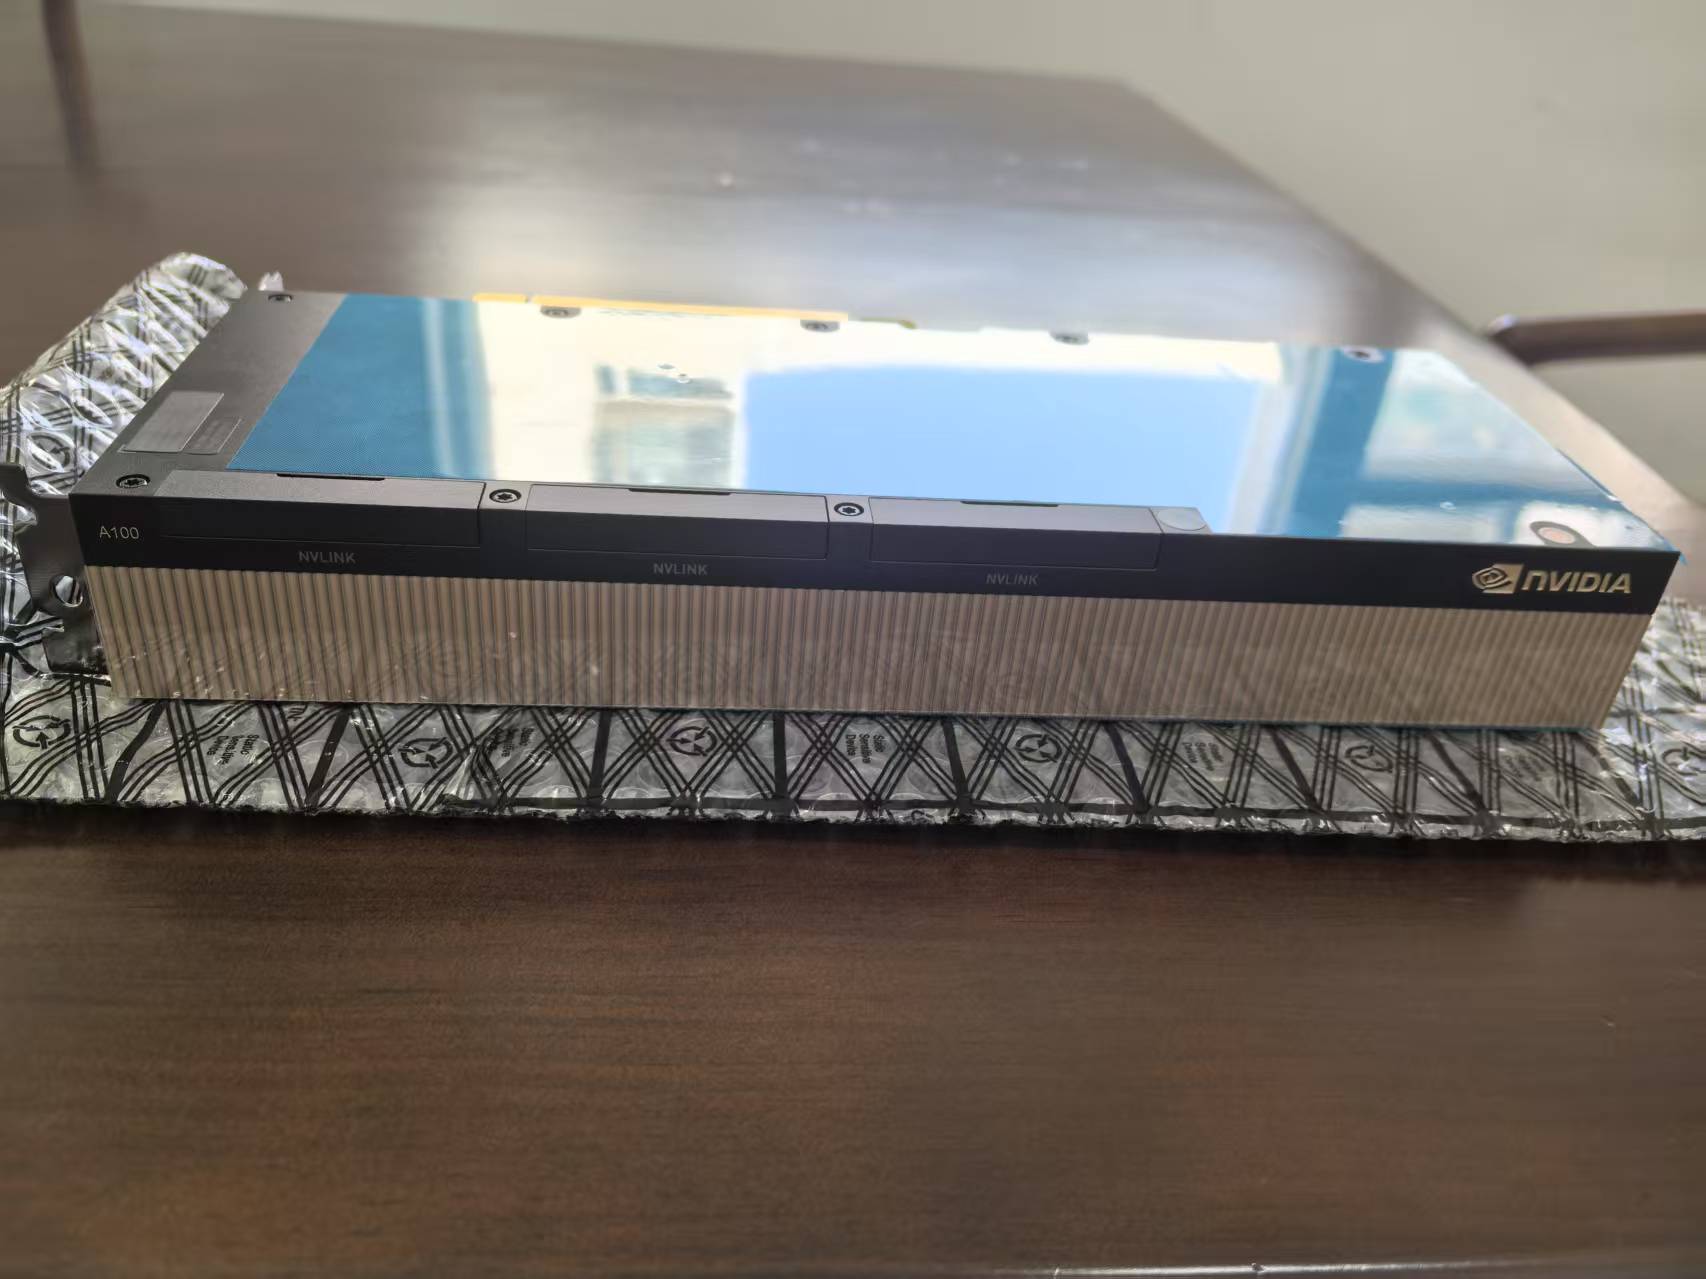
原装卡
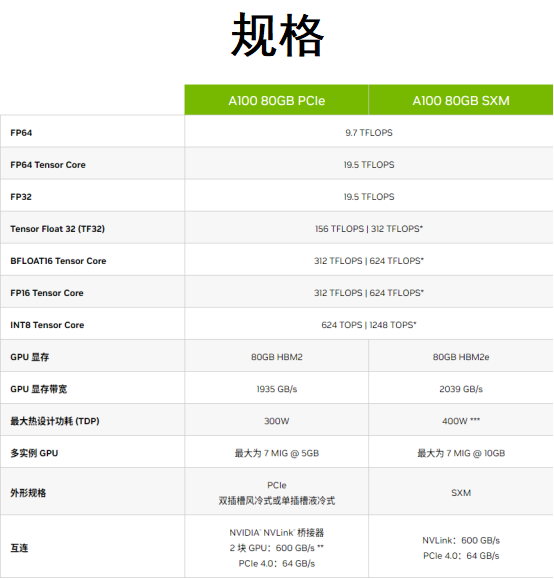
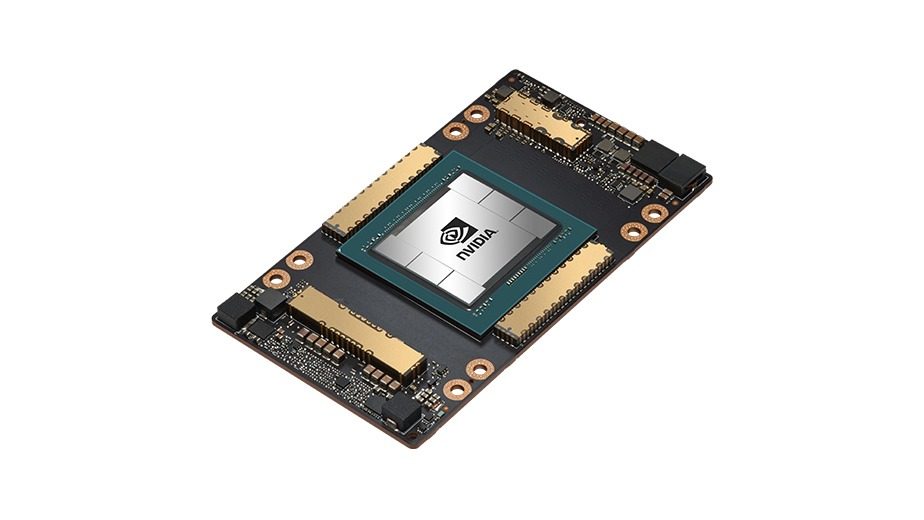
A100 80GBPCIE NVIDIA AI技术参数
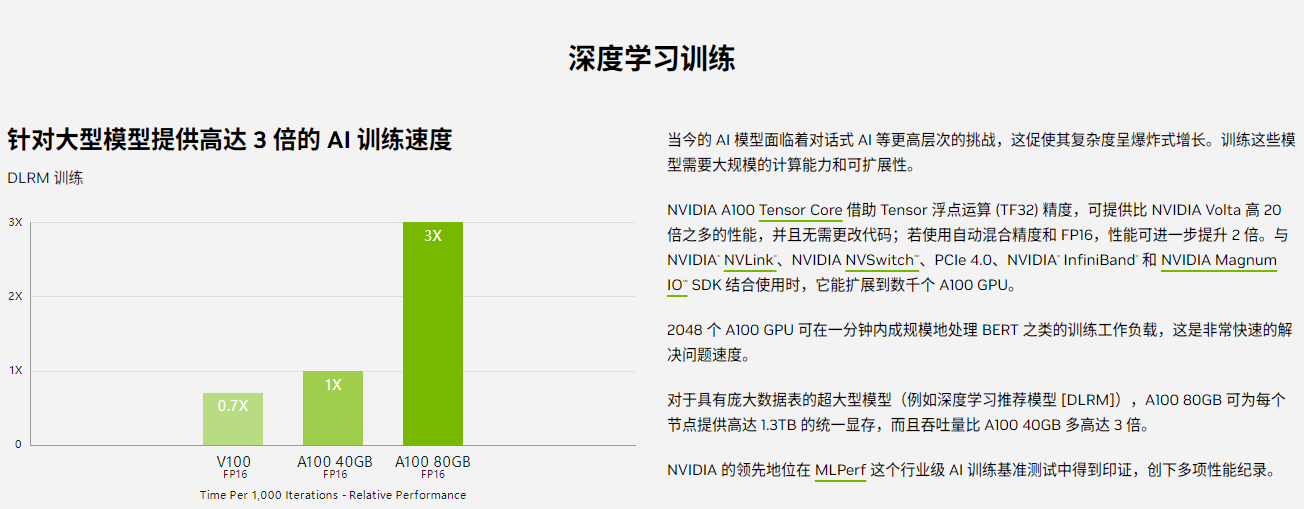
加速当今时代的重要工作NVIDIA A100 Tensor Core GPU 可针对 AI、数据分析和 HPC 应用场景,在不同规模下实现出色的加速,有效助力更高性能的弹性数据中心。A100 采用 NVIDIA Ampere 架构,是 NVIDIA 数据中心平台的引擎。A100 的性能比上一代产品提升高达 20 倍,并可划分为七个 GPU 实例,以根据变化的需求进行动态调整。A100 提供 40GB 和 80GB 显存两种版本,A100 80GB 将 GPU 显存增加了一倍,并提供超快速的显存带宽(每秒超过 2 万亿字节 [TB/s]),可处理超大型模型和数据集。
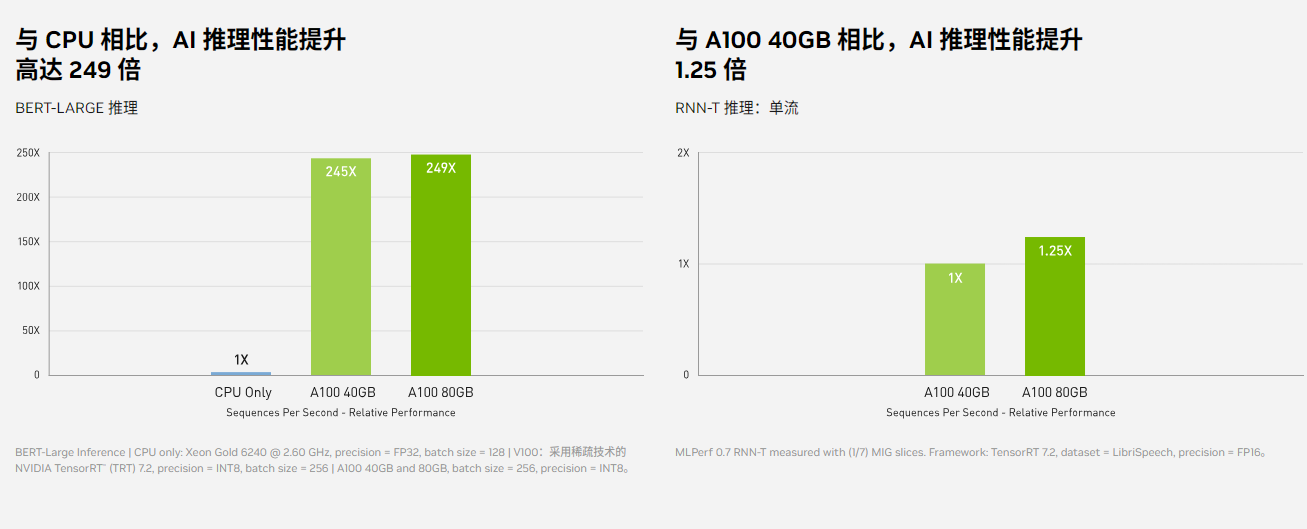
深度学习推理A100 引入了突破性的功能来优化推理工作负载。它能在从 FP32 到 INT4 的整个精度范围内进行加速。多实例 GPU (MIG) 技术允许多个网络同时基于单个 A100 运行,从而优化计算资源的利用率。在 A100 其他推理性能增益的基础之上,仅结构稀疏支持一项就能带来高达两倍的性能提升。在 BERT 等先进的对话式 AI 模型上,A100 可将推理吞吐量提升到高达 CPU 的 249 倍。在受到批量大小限制的极复杂模型(例如用于自动语音识别用途的 RNN-T)上,显存容量有所增加的 A100 80GB 能使每个 MIG 的大小增加一倍,并提供比 A100 40GB 高 1.25 倍的吞吐量。NVIDIA 产品的出色性能在 MLPerf 推理测试中得到验证。A100 再将性能提升了 20 倍,进一步扩大了这种性能优势。
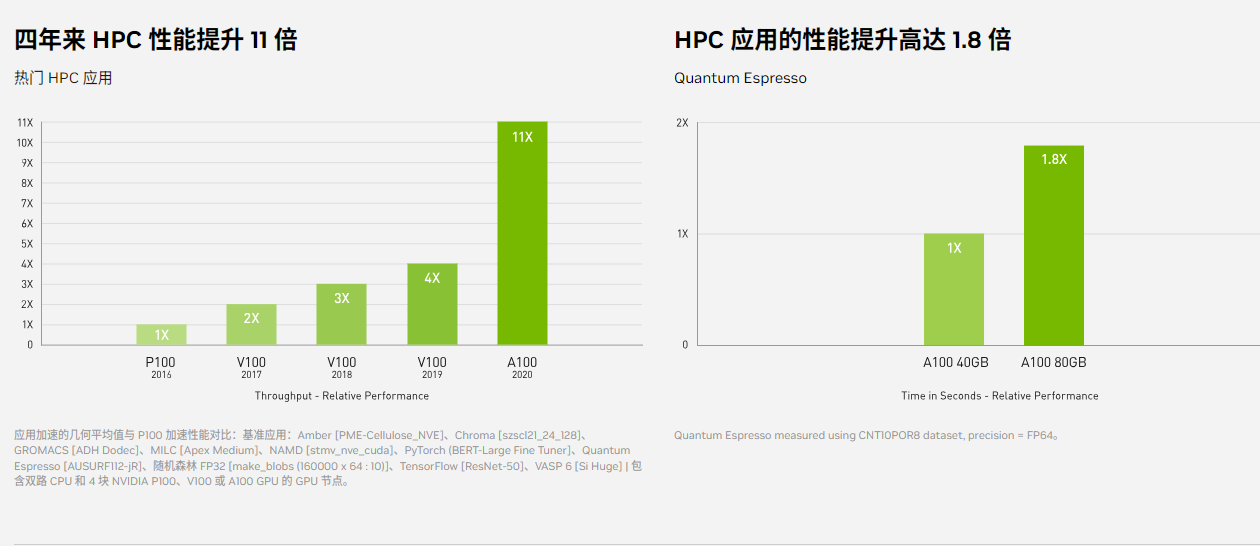
高性能计算为了获得新一代的发现成果,科学家们希望通过仿真来更好地了解我们周围的世界。NVIDIA A100 采用双精度 Tensor Core,实现了自 GPU 推出以来高性能计算性能的巨大飞跃。结合 80GB 的超快 GPU 显存,研究人员可以在 A100 上将 10 小时双精度仿真缩短到 4 小时以内。HPC 应用还可以利用 TF32 将单精度、密集矩阵乘法运算的吞吐量提高高达 10 倍。对于具有超大数据集的高性能计算应用,显存容量增加的 A100 80GB 可在运行材料仿真 Quantum Espresso 时将吞吐量提升高达 2 倍。极大的显存容量和超快速的显存带宽使 A100 80GB 非常适合用作新一代工作负载的平台。



 平台服务
 商户服务
 热门项目
 关于我们
 移动端


 微信公众号
 官方客服
 官方客服:185 0273 2643 商务/投资合作:189 0108 5156
 企业邮箱:chenfeiyu@cplight.com
