


主营:
AI服务器GPU/CPU/嵌入式软件/智算平台
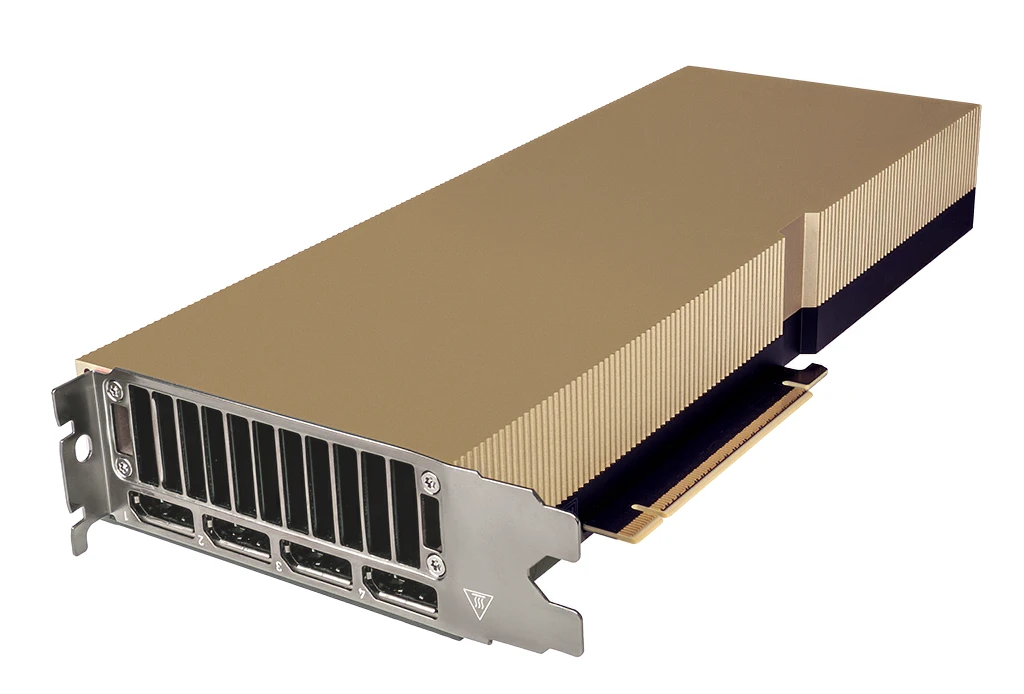
NVIDIA RTX PRO 6000 96GB(Blackwell)是英伟达 2025–2026 年推出的专业级 / 数据中心 GPU,分工作站版(风冷)和服务器版(被动散热),面向大模型训练 / 推理、科学计算、结构仿真、专业渲染,主打96GB 超大 ECC 显存 + 高算力 + 性价比
核心规格(工作站 / 服务器版一致)
架构:Blackwell(5nm)
CUDA 核心:24,064
Tensor Core:752 个(第 5 代,支持 FP4/FP16/TF32)
RT Core:188 个(第 4 代)
显存带宽:
工作站版:1,792 GB/s
服务器版:1,597 GB/s
FP32 算力:125 TFLOPS(工作站)/120 TFLOPS(服务器)
AI 算力(FP4):4,000 TOPS
功耗:600W(可配置)
接口:PCIe 5.0 x16
MIG:支持 4 个 MIG 实例(24GB / 个)
大模型训练 / 推理性能(重点)
1)显存优势(LLM 核心)
96GB ECC 显存:单卡可无量化加载 70B 模型(FP16);双卡可跑130B 模型;8 卡支持340B 模型训练 / 微调。
对比RTX 4090(24GB):显存4 倍,可直接跑70B,无需分片 / 量化(避免 10%–20% 精度损失)。
对比A100(80GB HBM2e):显存 **+20%**,带宽接近,成本低 40%+。
2)训练性能(FP16)
LLaMA‑2 70B(单卡):≈18–22 tokens/sec;8 卡≈140–170 tokens/sec。
Qwen‑72B(8 卡):训练吞吐量比RTX 4090 8 卡高 2.3 倍,接近A100 8 卡的 85%。
收敛速度:Blackwell 架构 + 第 5 代 Tensor Core,比 RTX 6000 Ada 快 2.5 倍。
3)推理性能(vLLM/FP16)
Llama‑2 70B(单卡):≈50–60 tokens/sec;INT8≈90–100 tokens/sec。
Qwen3‑4B(高并发):2,481 tokens/sec,比RTX 4090 快 2.2 倍。
70B 模型推理(8 卡):吞吐量达A100 8 卡的 90%,成本仅 60%。
4)结构仿真 / 科学计算
ANSYS ACP(百万单元):单卡求解速度≈RTX 4090 的 2.1 倍;8 卡≈双路 EPYC 7763+8×4090 的 1.4 倍。
CFD/FEA:FP32 算力125 TFLOPS,支持双精度加速,适合大规模工程仿真。
工作站版 vs 服务器版
工作站版(风冷):双槽、双风扇、满血 600W、带宽1,792 GB/s;适合单卡 / 4 卡工作站、室内环境、重负载。
服务器版(被动散热):双槽、无风扇、600W(需机箱散热)、带宽1,597 GB/s;适合8 卡机架服务器、数据中心、高密度部署。
典型场景与定位
✅ 政务 / 办公系统:OA、公文、邮件、虚拟化桌面
✅ 数据库 / 中间件:MySQL、PostgreSQL、达梦、金仓
✅ 信创替换:等保 2.0、密评、国产化替代项目
✅ 中小 AI 推理:BERT、YOLO、LLaMA-7B 推理 / 微调



 平台服务
 商户服务
 热门项目
 关于我们
 移动端


 微信公众号
 官方客服
 官方客服:185 0273 2643 商务/投资合作:189 0108 5156
 企业邮箱:chenfeiyu@cplight.com
