主营:
GPU/CPU/嵌入式HGX模组AI服务器
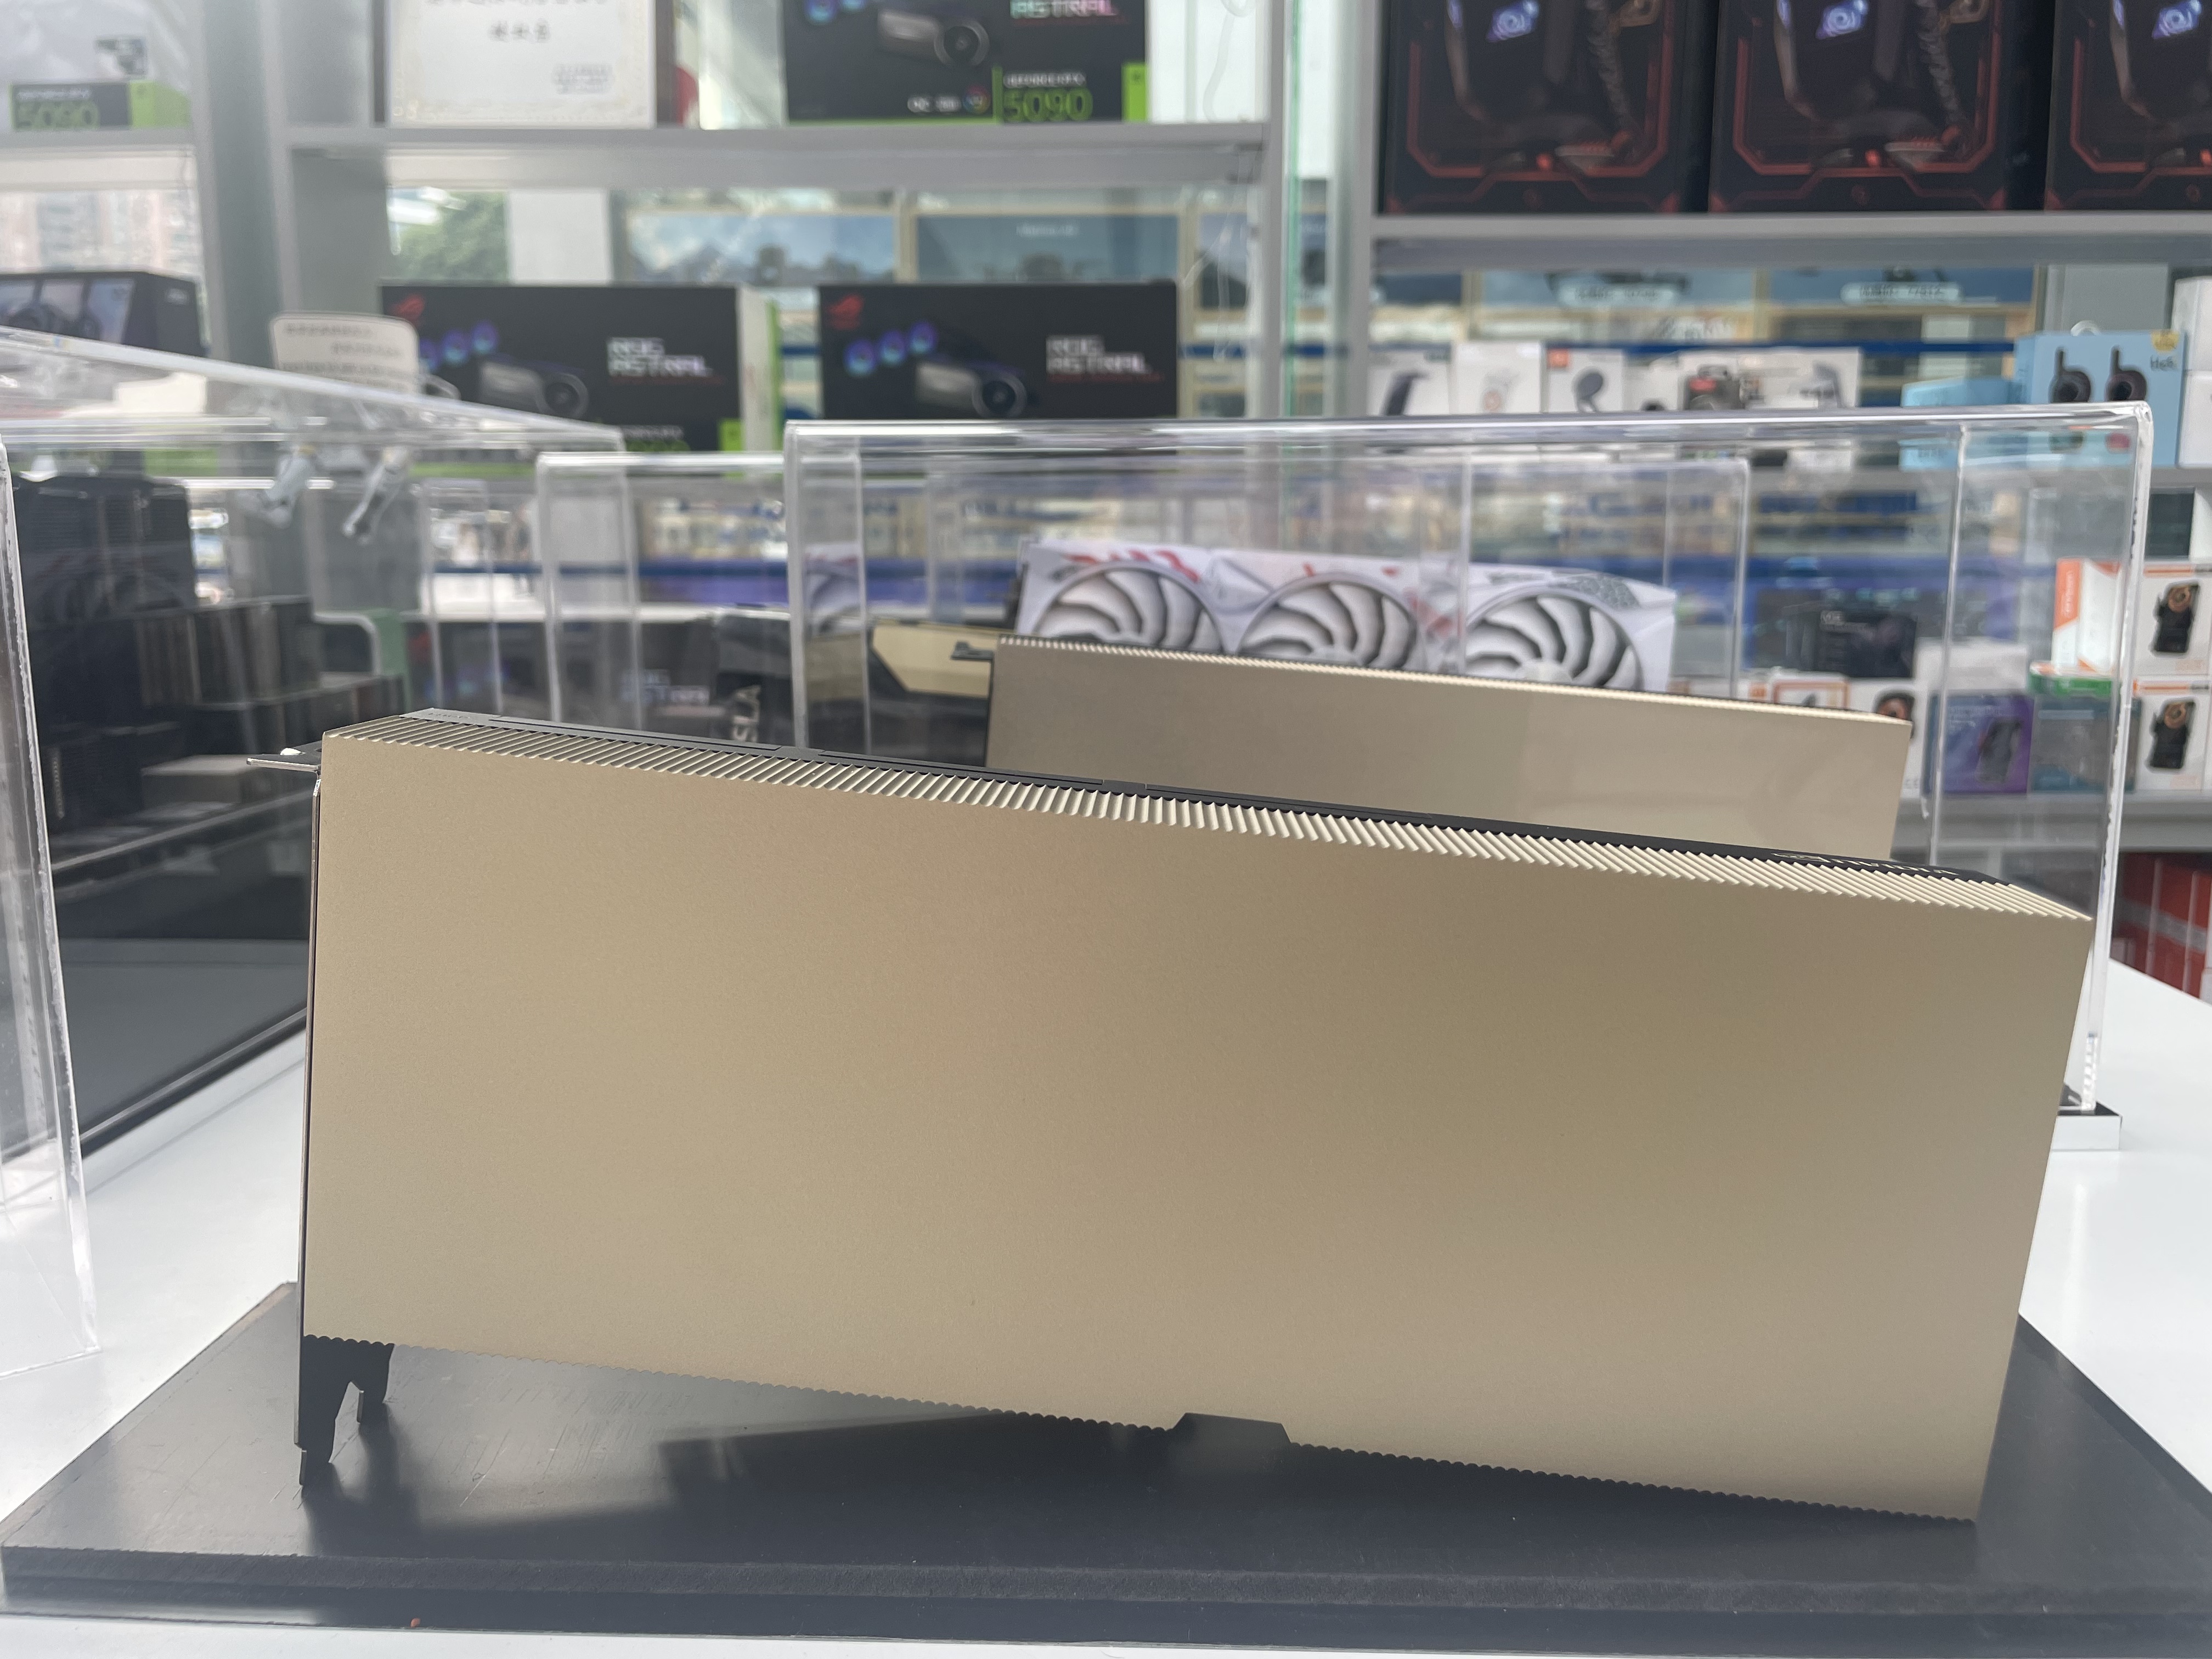
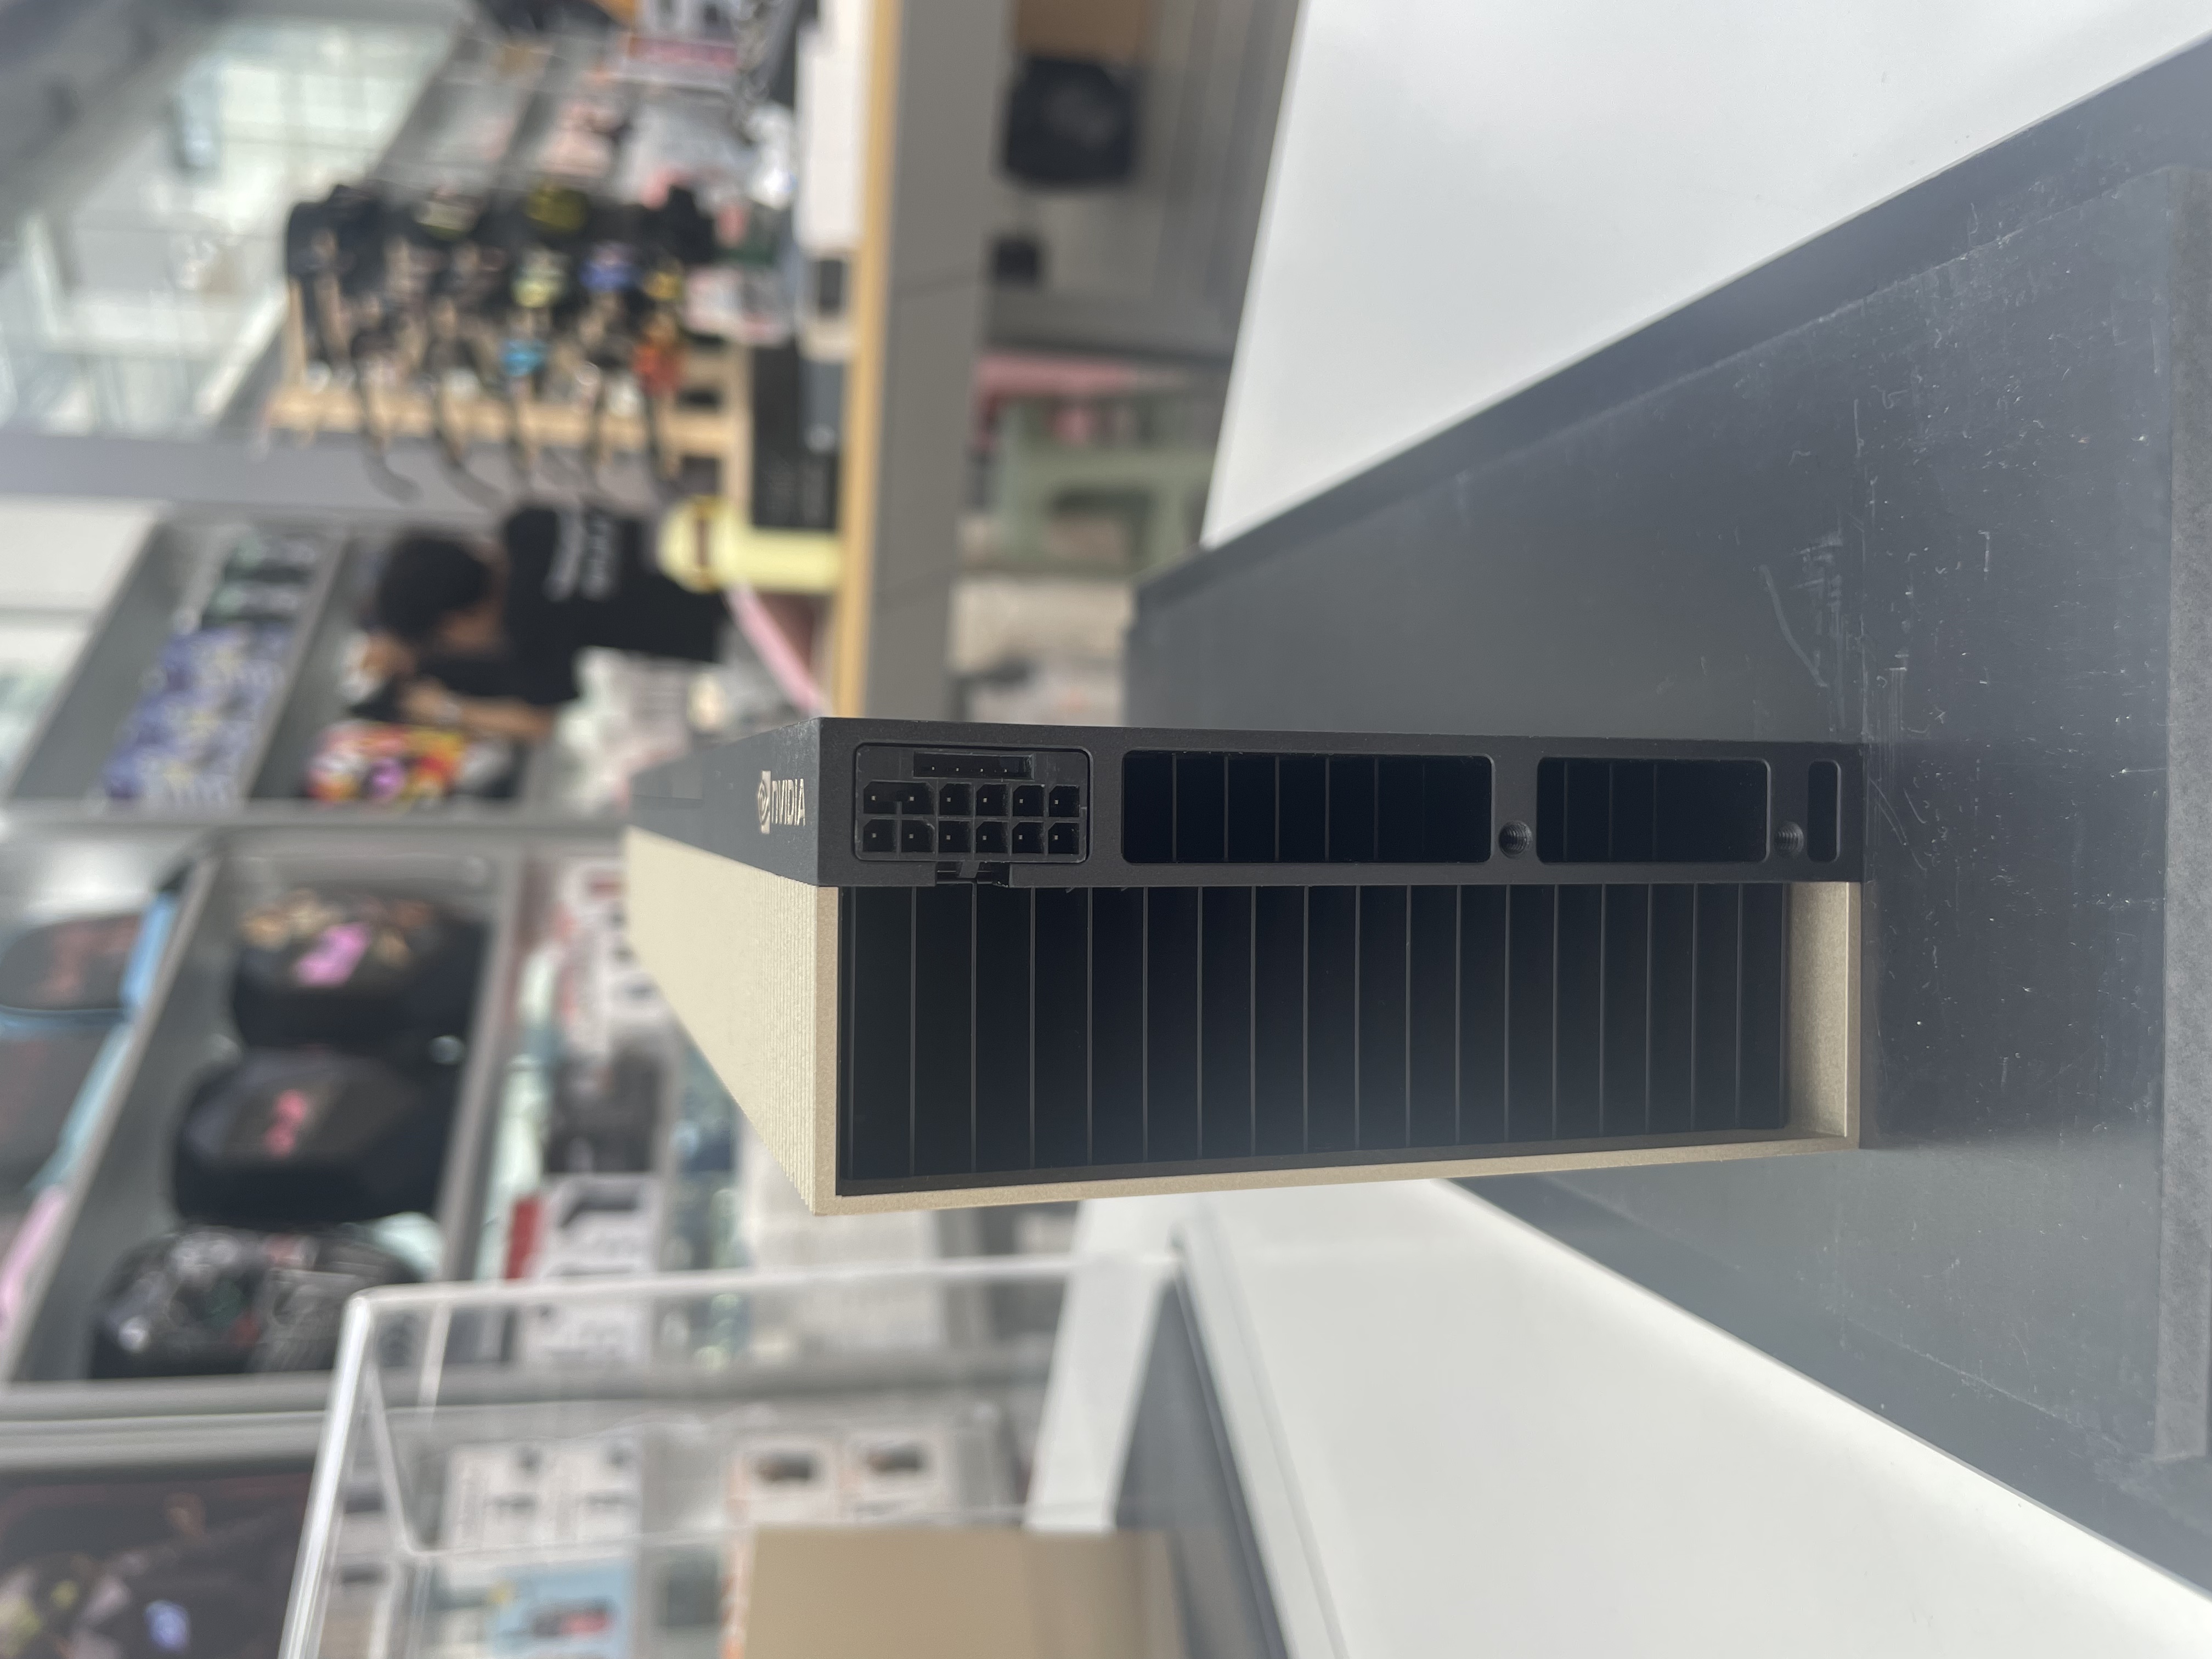
基于NVIDIA安培架构,6912个CUDA核心+432个Tensor Core,支持多精度计算,FP32达156TFLOPS、FP16达312TFLOPS,算力强劲。 40GB HBM2显存搭配1536GB/s带宽及40MB L2缓存,高效处理海量数据。 支持MIG技术(最多7个独立实例)与NVLink 3.0(600GB/s互联),提升资源利用率与多卡协同效率。定制散热+高品质元件,保障长时间稳定运行。
1. 澎湃算力:基于NVIDIA安培架构,集成6912个CUDA核心,拥有432个Tensor Core ,支持FP32、FP16、TF32等多种精度计算,FP32单精度性能达156TFLOPS,FP16性能高达312TFLOPS,为AI训练、科学计算等复杂任务提供强大算力。
2. 高效显存:搭载40GB HBM2显存,频率2.4Gbps,带宽达1536GB/s ,配合40MB的L2缓存,能快速处理海量数据,减少数据读取延迟,在大模型训练时优势显著。
3. 创新架构:支持多实例GPU(MIG)技术,单卡最多可划分7个独立实例,每个实例有独立计算、显存、缓存资源,不同任务并行不冲突,提升资源利用率。NVLink 3.0技术实现600GB/s高速互联,多卡协同通信延迟降低40%,适用于构建大规模算力集群 。
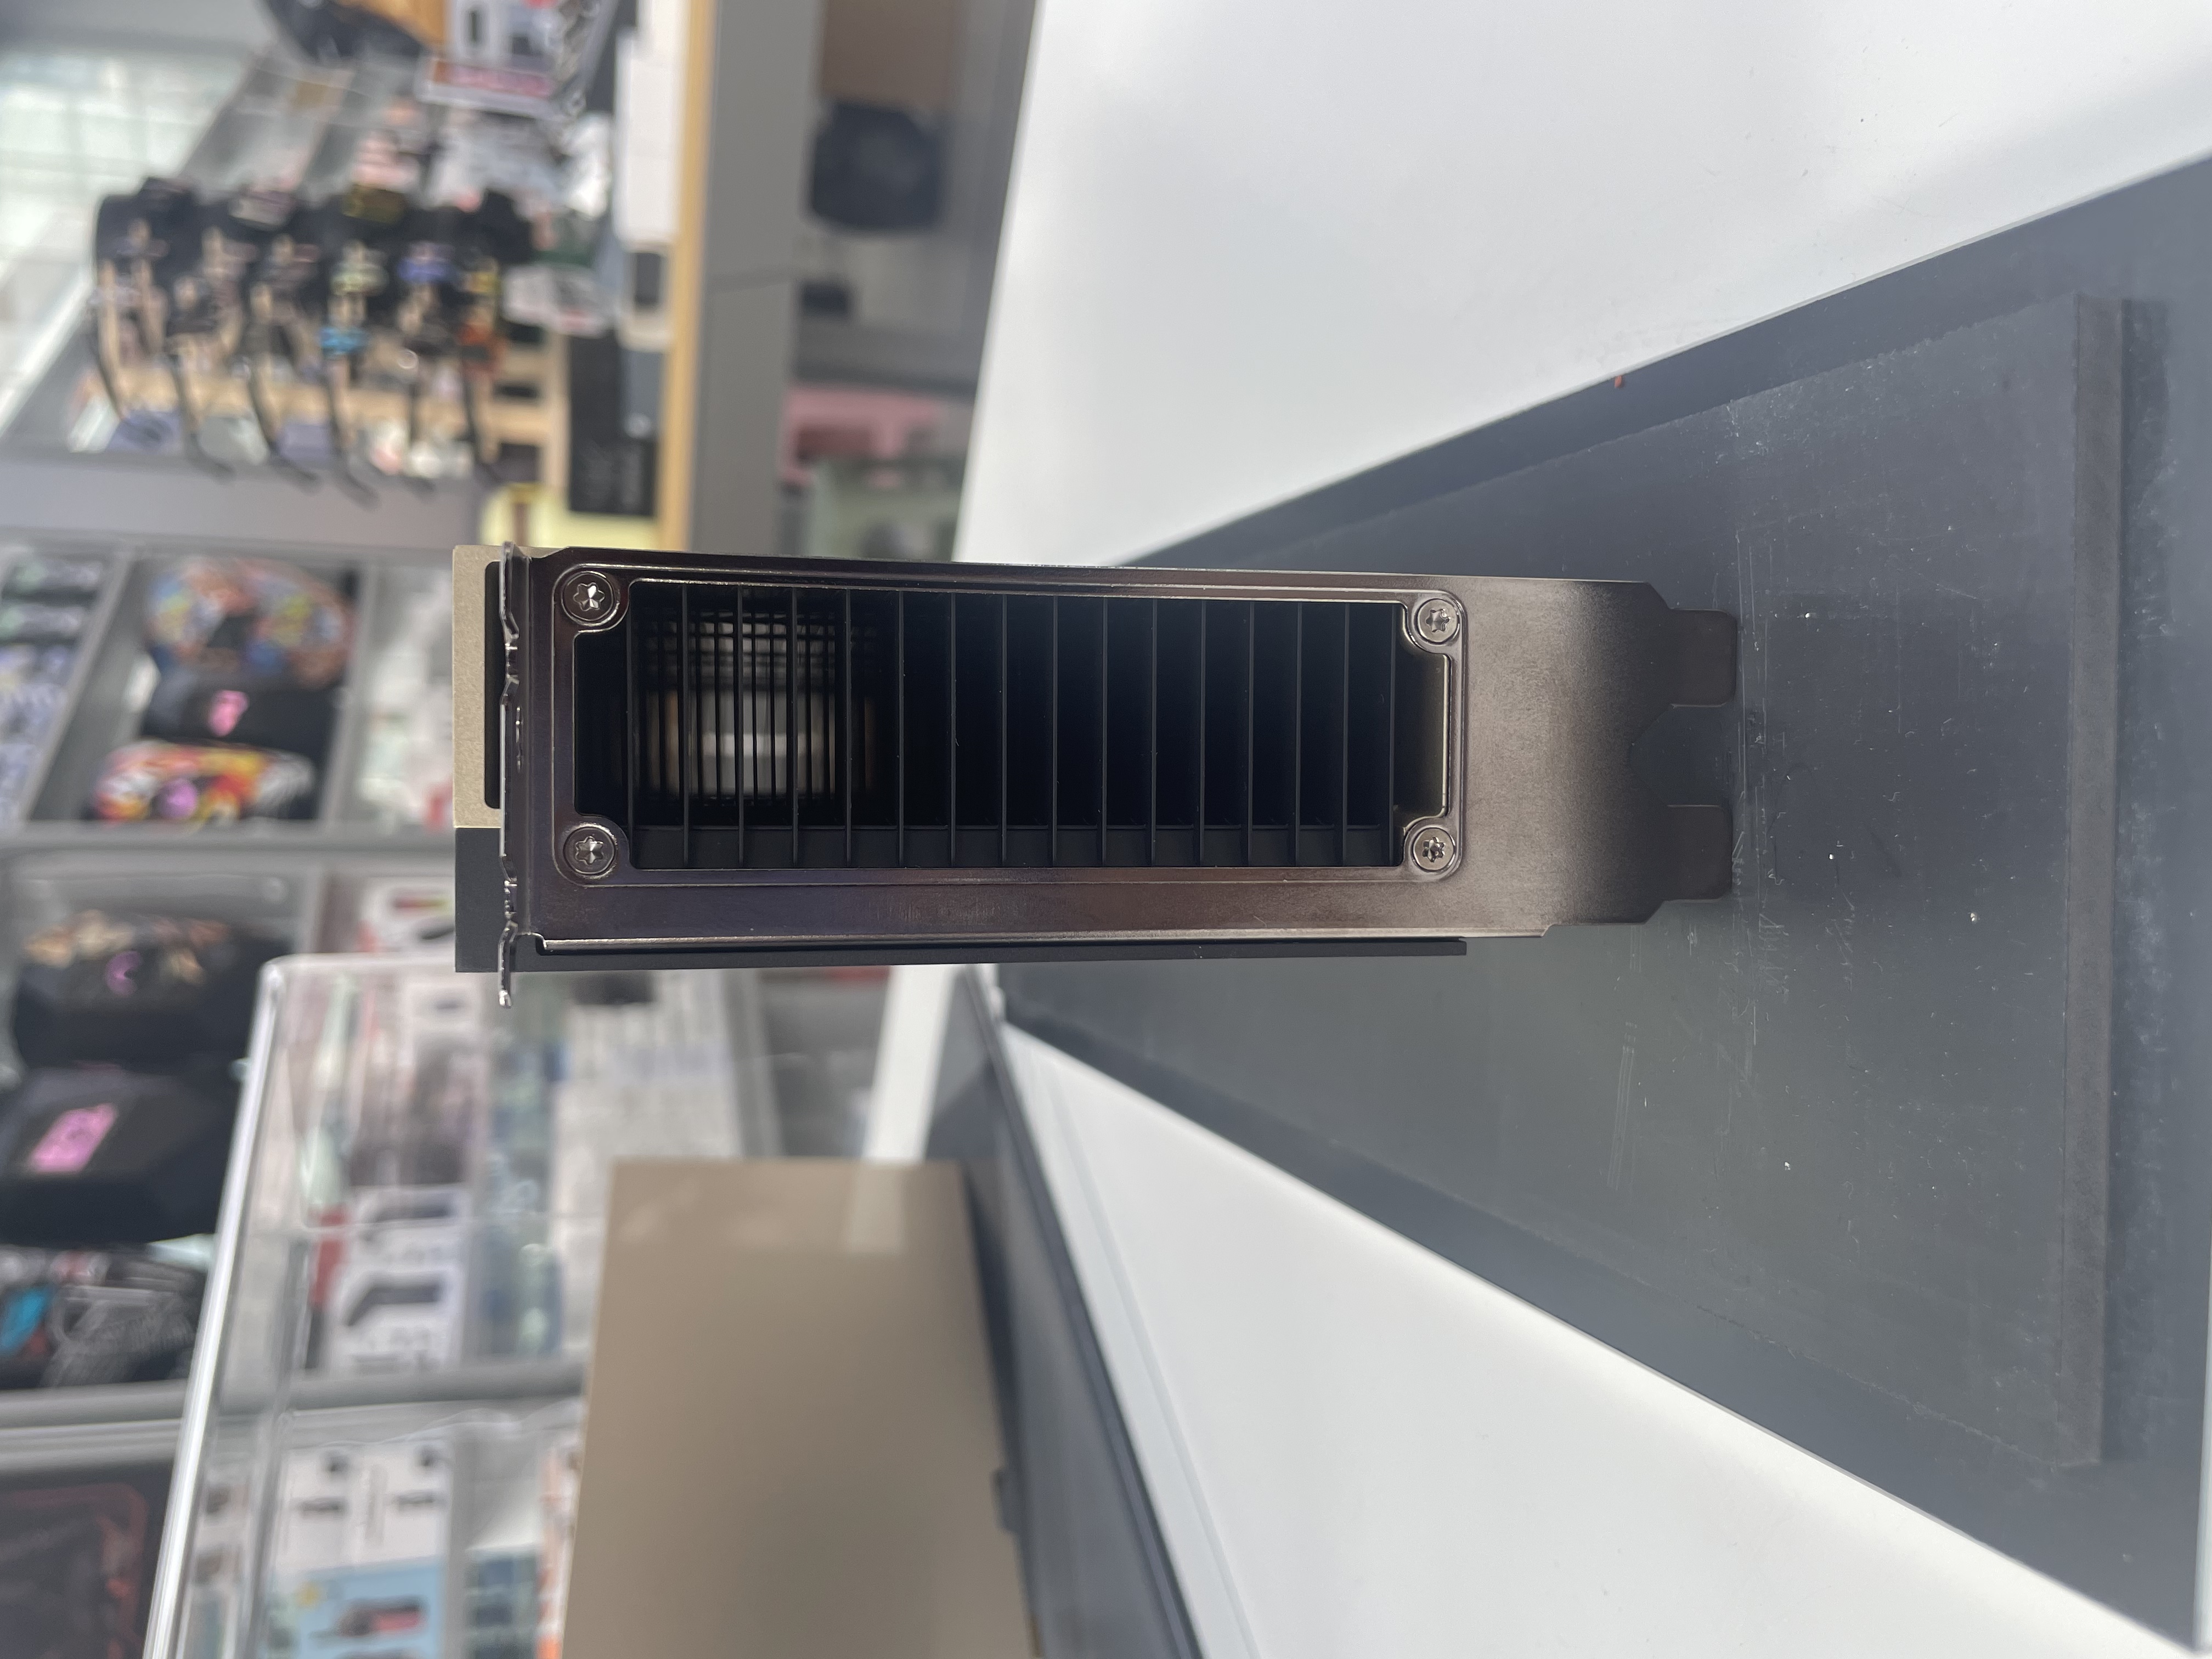
4. 稳定可靠:定制优化散热方案,确保高负载下稳定运行。采用高品质电气元件,经过严格测试,适应长时间、高强度工作需求。
 平台服务
 商户服务
 热门项目
 关于我们
 移动端


 微信公众号
 官方客服
 官方客服:185 0273 2643 商务/投资合作:189 0108 5156
 企业邮箱:chenfeiyu@cplight.com